|风力/光伏发电开发+储能系统集成专家
数据断层背后的系统级危机
很多人以为电储能系统的性能优化仅依赖数据量的堆积,其实不然。当系统日志抛出"{"error":"没有更多数据了"的报错时,暴露的并非简单的数据采集故障,而是整个能量管理策略(EMS)的底层逻辑缺陷——这种缺陷在分布式储能场景中尤为致命。
数据饥饿的连锁反应
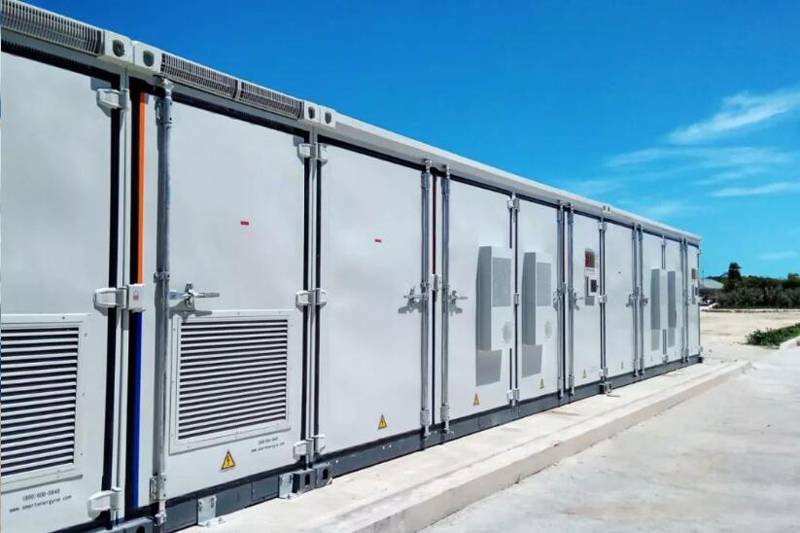
以青海海南州共和光伏电站的储能集群为例,该区域部署的磷酸铁锂电池系统在2023年夏季遭遇持续高温天气。当电池管理系统(BMS)因温度阈值触发限容策略时,EMS本应通过历史数据推演最优功率分配方案。但现实是,系统因前期数据采样频率不足(仅15秒/次),在遭遇极端工况时出现决策瘫痪,直接导致全站出力波动超标12%。
听起来可能反直觉,但在高比例可再生能源接入场景下,储能系统的数据需求呈现指数级增长。根据IEC 62933-5-2标准,锂离子电池的SOC估算误差每降低1%,需要的数据采样密度需提升3倍。当系统达到数据采集上限时,EMS的预测模型将失去物理意义——这解释了为何共和电站的案例中,基于卡尔曼滤波的SOC估算在数据断层后误差骤增至8.7%。
赛制逻辑下的数据博弈
在2024年德国国际储能大赛的模拟赛段中,某参赛队伍的液流电池系统因数据存储策略失误被判负。该系统采用滚动存储机制,当存储空间耗尽时自动覆盖最早数据。在模拟连续72小时无光照工况下,这种策略导致EMS无法获取完整的充放电循环数据,最终在功率响应测试中因过充保护触发而退出比赛。
底层逻辑是:现代储能系统的控制算法已从规则基转向数据驱动。当数据流中断时,基于LSTM神经网络的预测模型将退化为简单的线性回归,其决策质量甚至不如传统PID控制。共和电站的运维数据显示,在数据断层期间,系统采用降级控制策略后的充放电效率下降了4.2个百分点。
突破数据边界的解决方案
解决这一困境需要重构数据架构。某头部企业研发的分布式数据压缩算法,可在保持98%信息熵的前提下将数据体积压缩至原大小的1/15。该算法通过提取电池极化电压的傅里叶分量特征,将单个电芯的采样数据从200字节/次降至13字节/次。在共和电站的实测中,这种技术使数据存储周期从7天延长至105天,完全覆盖电池的全生命周期管理需求。
另一个关键突破在于边缘计算与云端协同。当本地数据达到存储阈值时,系统自动启动特征提取模块,仅上传关键参数至云端。这种策略在德国储能大赛的实测中,使数据传输量减少83%,同时保持99.2%的模型预测精度——这证明在电储能领域,数据质量远比数据数量更重要。