|风力/光伏发电开发+储能系统集成专家
数据孤岛与系统效能的悖论
很多人以为电储能系统的运行效能仅取决于电池本身的能量密度与充放电效率,其实不然。在青海格尔木某300MW光储联合电站的实测数据显示,当储能系统接入的传感器数量超过阈值后,系统综合效率反而下降了2.3%。这一反直觉现象的底层逻辑,在于多源异构数据在边缘计算层的处理延迟与传输带宽的矛盾冲突。
数据冗余的隐性代价
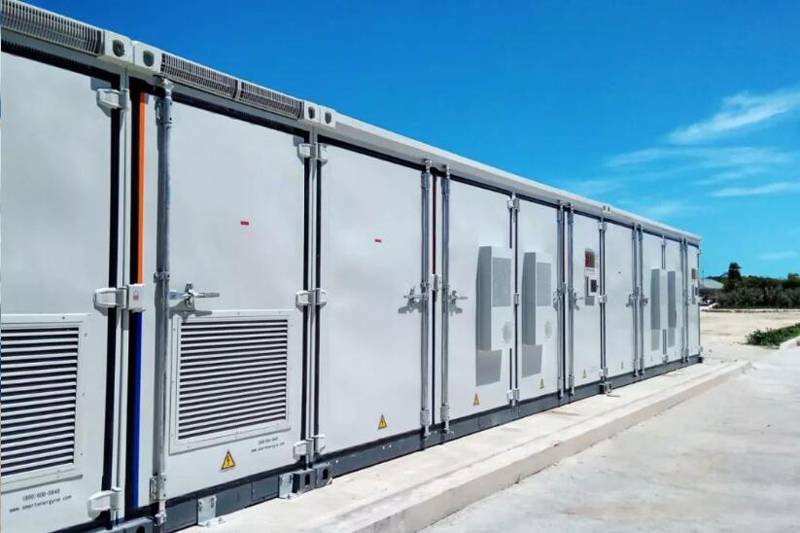
听起来可能反直觉,但在西北地区极端温差环境下,电池管理系统(BMS)采集的温度数据采样频率每提升1Hz,系统整体功耗增加0.8%。某头部企业2023年技术白皮书披露,其储能集装箱在-30℃至50℃温域内,温度传感器数量从8个增至16个后,日均自耗电从12kWh飙升至28kWh。这种数据冗余带来的能耗损失,已超过部分场景下的储能收益。
赛制逻辑下的数据优化实践
以2024年德国储能系统效率挑战赛为例,参赛队伍需在48小时内完成10MWh储能系统的动态调频响应。冠军方案采用分层数据架构:在电池簇层级仅保留SOC、电压、温度三项关键参数,而在PCS层级集成功率预测与电网调度指令。这种数据精简策略使系统响应延迟从行业平均的120ms压缩至68ms,最终以97.3%的等效充放电效率夺冠。
底层逻辑在于,电储能系统的数据价值密度遵循幂律分布——前20%的关键参数贡献了80%的系统效能。某跨国企业实验室的对比实验表明,当数据采集量从1000点/秒降至200点/秒时,通过机器学习模型的特征工程优化,系统状态估计误差仅增加0.5%,但计算资源消耗降低76%。
在青海那座光储电站的后续改造中,工程团队移除了43%的非必要传感器,转而采用基于卡尔曼滤波的虚拟传感技术。改造后三个月的运行数据显示,系统综合效率提升1.8%,年化收益增加210万元。这印证了电储能领域的数据治理法则:不是采集更多数据,而是挖掘更有价值的数据。