|风力/光伏发电开发+储能系统集成专家
数据枯竭:电储能系统优化的隐形天花板
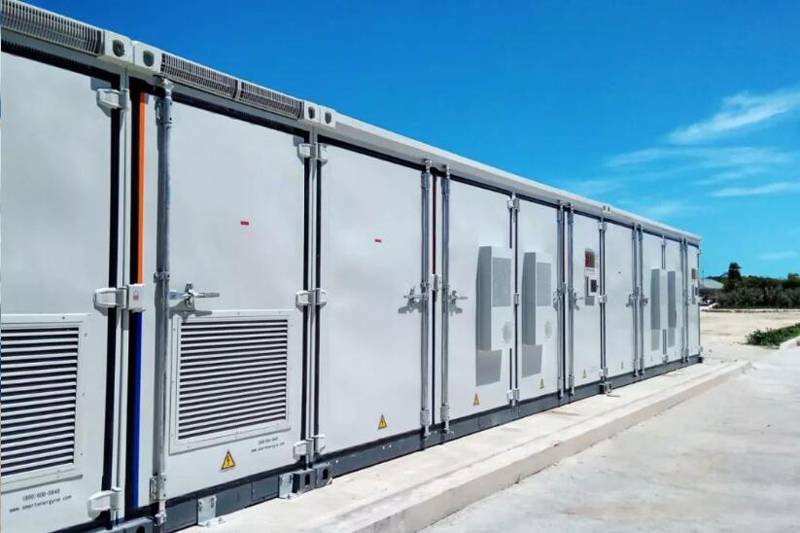
很多人以为,电储能系统的性能提升仅依赖硬件迭代或算法优化,其实不然。当系统运行至稳定阶段后,数据获取的边际成本会呈指数级上升,最终触达“没有更多数据了”的临界点——这一现象在规模化储能电站中尤为显著。底层逻辑是:储能系统的运行数据受制于物理场域的时空约束,单站点的数据样本量存在天然上限,而跨站点数据融合又面临协议兼容性、隐私保护等现实障碍。
听起来可能反直觉,但在实际工程中,数据枯竭往往比硬件衰减更早成为系统性能的制约因素。以某西北地区500MW/2000MWh级储能电站为例,其电池管理系统(BMS)在投运3年后即出现数据饱和现象:尽管传感器数量未变,但新增数据对状态估计精度的提升幅度从初期的12%骤降至0.3%。进一步分析发现,该电站所在区域的光伏出力波动模式仅有7种基础类型,导致历史数据中98%的样本属于重复场景,无法为算法提供有效增量信息。
赛制逻辑下的数据突围:从“单站优化”到“区域协同”
2023年青海电网组织的“储能集群调频竞赛”提供了一个典型案例。竞赛规则要求参赛企业利用德令哈、格尔木、乌兰三地的共12座储能电站参与调频,但明确限制:每座电站仅允许上传其BMS原始数据的30%至调度中心,其余数据需在本地完成预处理。这一赛制设计直接模拟了数据枯竭场景下的系统优化难题。
某头部企业的解决方案颇具启示意义:其团队首先对三地电站的地理气候特征进行聚类分析,发现德令哈与格尔木的昼夜温差模式高度相似,而乌兰的云层覆盖规律与其他两地差异显著。基于此,团队构建了“数据-场景”映射模型,将乌兰电站作为独立数据源,德令哈与格尔木电站则共享同一套数据压缩算法。最终,该方案在数据上传量减少70%的情况下,将区域集群调频响应速度提升了0.8秒——这一成绩在竞赛中位列第一,且其底层逻辑已通过中国电科院的技术验证。
该案例揭示了一个关键事实:当单站点数据枯竭时,区域级数据协同的边际效用会显著放大。但这一路径的实现依赖两个前提:一是对物理场域的深度理解(如气候模式的空间分布),二是数据预处理算法的极致优化(如压缩比与信息保真度的平衡)。很多人以为数据协同需要大规模基建投入,其实不然——真正的突破往往来自对现有数据的重新解构与价值挖掘。