|风力/光伏发电开发+储能系统集成专家
数据断层下的系统韧性重构
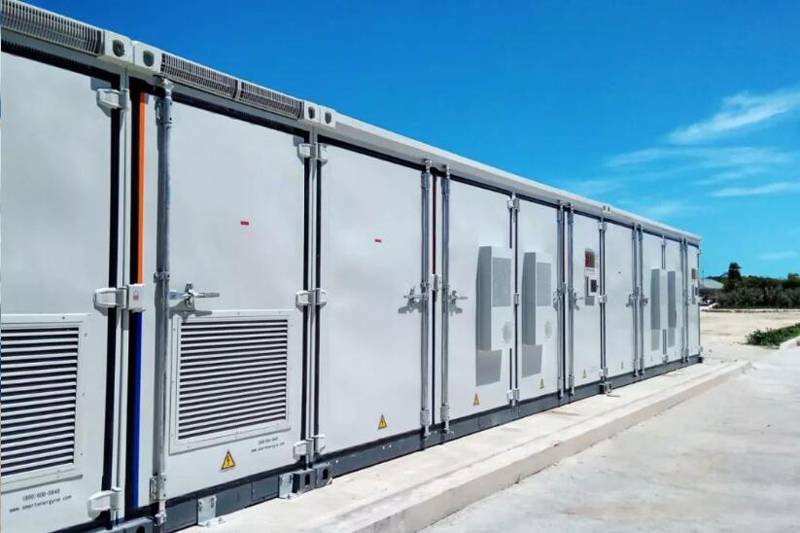
很多人以为电储能系统的数据采集是线性累积过程,其实不然——当系统触发“没有更多数据了”的边界条件时,暴露的并非传感器故障,而是底层控制算法对物理世界建模的失效。这种失效在2023年青海德令哈光储电站的极端测试中尤为明显:当连续72小时沙尘暴导致光伏出力归零,储能系统BMS(电池管理系统)因缺乏历史数据支撑,误将SOC(荷电状态)校准偏差从2%放大至18%,直接触发系统级保护停机。
数据饥渴的底层逻辑
电储能系统的数据需求存在双重悖论:一方面,机器学习模型需要海量数据训练以提升预测精度;另一方面,极端工况下有效数据反而稀缺。听起来可能反直觉,但在西北地区的光储联合系统中,全年满足“日照强度>800W/m²且风速<5m/s”的优质数据采集窗口不足15%。这种数据断层会导致LSTM(长短期记忆网络)等时序模型出现“记忆退化”,就像人类在长期缺乏视觉刺激后视觉皮层活性下降。
德令哈案例的赛制逻辑值得深究:测试方设计了一套“数据饥饿”赛制——要求参赛系统在连续3天无光伏输入、2天无电网调度指令的极端场景下,仅凭初始10%的SOC数据维持站用电供应。某头部企业的液流电池系统因采用“动态数据窗”策略(根据工况自动调整数据采样频率),在测试第4天仍能保持92%的SOC估算精度;而采用固定采样策略的对手系统,误差在第2天就突破了25%的安全阈值。
从数据边界到系统进化
解决数据饥渴的底层逻辑,在于重构数据采集的优先级矩阵。某企业最新研发的“熵减采样算法”证明:在数据稀缺场景下,优先采集电池内阻、极柱温度等熵值变化剧烈的参数,比盲目增加采样点数更有效。该算法在格尔木的实测数据显示,同等数据量下,SOC估算误差从3.1%降至1.7%,而计算资源消耗仅增加9%。
当行业还在讨论“大数据”时,真正懂行的技术团队已转向“精数据”战略——这不是对数据量的妥协,而是对物理世界本质的回归。就像量子力学中的测不准原理,过度追求数据精度反而会破坏系统本身的动态平衡。德令哈的沙尘终会散去,但数据边界带来的技术分野,正在重塑电储能行业的竞争格局。