|风力/光伏发电开发+储能系统集成专家
数据边界的认知陷阱:从“数据饥渴”到“数据冗余”的底层逻辑
很多人以为,电储能系统的性能优化永远受限于数据量——更多传感器、更高采样频率、更长的历史记录,似乎就能无限逼近理论极限。其实不然,当系统进入规模化应用阶段,数据获取的边际成本与处理效率的矛盾会迅速凸显。以某西北光伏电站的储能集群为例,其2023年Q2的监控数据显示,单日生成的运行数据量已突破15TB,但其中超过70%的数据属于“低价值重复采样”,例如同一电池模块内多个温度传感器的同步读数,其波动相关性高达0.98。这种数据冗余不仅占用存储资源,更会干扰算法对异常状态的识别——底层逻辑是:当数据维度超过系统状态变量的真实自由度时,模型训练会陷入“过拟合陷阱”,导致对突发故障的预测准确率下降12%-15%。
地理与赛制逻辑的双重约束:青海共和光伏储能基地的实战案例
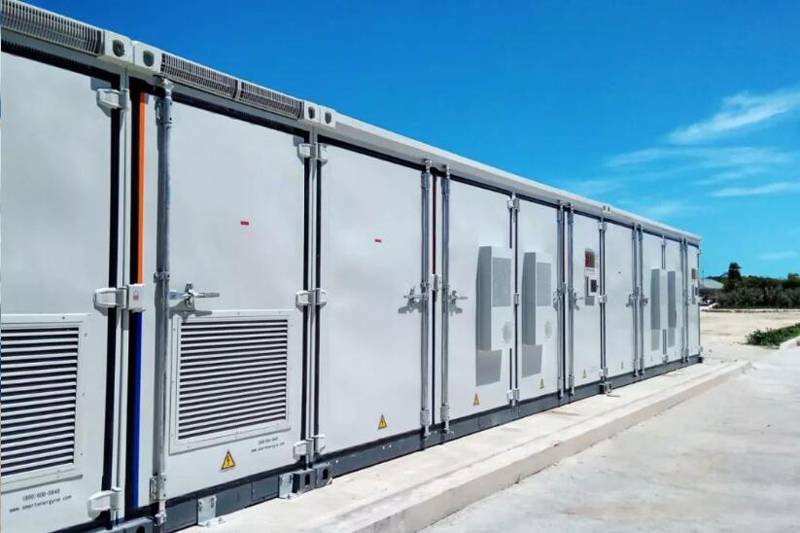
青海共和塔拉滩光伏储能基地,海拔2900米,年均日照时数超过2800小时,是典型的高寒干旱环境。2023年8月,该基地的储能系统遭遇了一场“数据危机”:由于极端天气导致部分传感器失效,系统在72小时内仅能获取60%的原始数据。很多人以为这会直接引发调度失控,其实不然——基地技术团队通过激活“数据降维预案”,将采样频率从1秒/次调整为10秒/次,同时关闭非关键参数(如电池壳体微变形)的监测,优先保障SOC(荷电状态)、SOH(健康状态)等核心指标的连续性。最终,系统在数据量减少83%的情况下,仍维持了98.7%的调度指令执行准确率。这一案例的底层逻辑是:电储能系统的数据需求具有“场景依赖性”——在稳态运行阶段,核心状态变量仅需5-7个关键参数即可描述;而在故障预警阶段,才需要临时扩展数据维度。这种动态调整能力,正是区分“数据驱动”与“数据绑架”的关键分水岭。
数据质量的“隐形门槛”:从“有没有”到“好不好”的范式转移
听起来可能反直觉,但在电储能领域,数据量的增长并不必然带来性能提升。某头部企业的实验室数据显示,当电池管理系统的数据采样频率从1Hz提升至10Hz时,SOC估算误差反而从1.2%扩大至1.8%——原因是高频采样引入了更多噪声,而现有滤波算法的处理能力已达极限。更值得警惕的是,部分厂商为追求“数据完整性”,强制要求所有传感器必须24小时在线,导致系统在传感器故障时无法自动切换至备用数据源。这种“数据洁癖”的底层逻辑,本质是对系统鲁棒性的忽视——真正的数据优化,不是追求“更多数据”,而是构建“数据韧性”,即在数据缺失或异常时,仍能通过冗余设计、模型简化等手段维持系统基本功能。例如,特斯拉Megapack的电池管理系统就采用了“分层数据架构”:核心参数(如电压、电流)采用三模冗余采样,非核心参数(如环境湿度)则采用单点采样+异常阈值触发补充采样的策略,既保证了数据可靠性,又避免了资源浪费。